#薄膜铌酸锂 #电光调制器 #光量子器件
摘要
高斯玻色采样(GBS)已成为展示量子计算优势的领先光子学范式。然而,最先进的 GBS 装置面临着实际障碍,包括严格的光学对准、相位不稳定性和有限的可编程性,这些障碍阻碍了可扩展的工程部署。芯片级时空复用架构有望解决这些限制,但它强烈要求晶圆级芯片能力,以同时满足低损耗、高精度和高速调制的严格要求。在此,我们报道了首个芯片级时空复用 GBS 系统,在薄膜铌酸锂芯片上单片集成了高速电光调制器、片上延迟线和时空复用干涉网络,以 4 GHz 时钟速率运行,在 1 毫秒内检测到多达 11,059 个光子事件。除了基准测试量子优势之外,我们还将光子硬件重新配置为 GBS 驱动的世界模型,用于建模物理动力学,与经典回声状态网络(ESN)基线相比,该模型以更少的可训练读出参数实现了更低的预测误差。我们的结果验证了我们朝着可扩展光子量子硬件努力的可行性,并为未来 GBS 量子系统的多功能可编程应用铺平了道路。
划重点--销售晶圆和加工
#离子注入铒#光子晶体腔电子束光刻刻蚀加工
468寸PLZTOI薄膜晶圆--180pm/V电光系数高
SOI晶圆:--220nm/340nm/500nm薄膜/ 3um厚膜-3umSIO2-675um,1万欧双高阻做探测器和量子器件
GEOI晶圆--做探测器和中远红外波导,SMARTCUT工艺
InGaPOI晶圆:2阶和3阶非线性器件--mbeAlGaAsOI晶圆:非线性器件--mbe
ALNOI晶圆;紫外波导器件和紫外非线性器件
ALOOI晶圆;--氧化铝薄膜晶圆,键合工艺和镀膜工艺--紫外波导器件
TAOOI晶圆--氧化钽薄膜晶圆,离子束溅射镀膜工艺,吸收小损耗低
SINOI晶圆--超低损耗LPCVD+annealing氮化硅薄膜晶圆,210nm-300nm-400nm-800nm
SICOI晶圆;新型光量子波导平台减薄抛光工艺500nm-700nm-1um
8寸LTOI晶圆批量供应;铌酸锂的有力的竞争对手,薄膜钽酸锂晶300600
6寸X切Z切掺镁薄膜铌酸锂晶圆 ,厚膜 3um 5um 和 薄膜 100-600nm
8寸LNOI晶圆;8寸LNOI助力更大规模薄膜铌酸锂产品量产
流片: 6寸 氮化硅 铌酸锂 硅光 超高性价比流片, 1个BLOCK的价格买一整片晶圆
划重点--全国产-超高性价比-6 寸硅光-氮化硅-铌酸锂流片白皮书
我们为客户提供晶圆(硅晶圆,玻璃晶圆,SOI晶圆,GaAs,蓝宝石,碳化硅(导电,非绝缘),Ga2O3,金刚石,GaN(外延片/衬底)),镀膜(PVD,cvd,Ald,PLD)和材料(Au Cu Ag Pt Al Cr Ti Ni Sio2 Tio2 Ti3O5,Ta2O5,ZrO2,TiN,ALN,ZnO,HfO2。。更多材料),键合(石英石英键合,蓝宝石蓝宝石键合)光刻,高精度掩模版,外延,掺杂,电子束光刻等产品及加工服务(请找小编领取我们晶圆标品库存列表,为您的科学实验加速。
请联系小编免费获取原文
引言
追求量子计算优势,即在特定任务上超越最先进的经典超级计算机,是量子计算中最关键的里程碑之一。自从超导 Sycamore 处理器首次宣称这种优势以来 [1],光子学系统已经出现,并且这些仍然是迄今为止能够实现该优势的两种物理量子系统 [2, 3],各自开辟了独特的可扩展性路径。在光子学系统中,玻色采样 [4–8] 及其变体,特别是高斯玻色采样(GBS)[9],是展示量子优势的代表性范式,因为在一般情况下精确评估其输出概率是 #P-hard 的。一批实验已经在光子学中展示了量子计算优势 [3, 10–14]。其中一些通过级联干涉仪建立了自由空间路线,而致远 [10] 和 Borealis [11] 引入了时域复用方案,并展示了以适度的物理资源实现大规模等效干涉网络。近年来,经典模拟能力不断增强,高损耗已被证明会削弱 GBS 的经典不可计算性 [15],这对宣称量子计算优势提出了更严格的要求。
随着系统规模和复杂性的增长,稳定性和可制造性成为工程部署的主要实际瓶颈。自由空间体光学中的原理验证实现极大地受制于精细对准的困难、稳定性的缺乏以及极弱的可编程性,这对应用研究是不利的。全光纤方法虽然已经证实了时域复用策略的可行性 [11, 16–26],但仍可能受到相位稳定性和空间资源利用不足的限制。
我们对挑战进行了整体评估,并提出该路线必须诉诸芯片级集成:当在芯片上交织多环时间级联和多层马赫-曾德尔干涉仪(MZI)空间网络,并辅以热光和高速电光移相器 [27, 28] 时,时间模和空间模的完全混合可以按需精确设计,从而从根本上解决可扩展性和可编程性问题。为了实现时空复用方案 [29],我们必须实现极高的调制速度,以允许芯片上用于时间仓操作的中等延迟环长度,并且我们必须不断降低芯片上的各种损耗以确保空间可扩展性。只有同时满足所有这些工程挑战,我们才能突破芯片上时空复用的瓶颈。
在本文中,我们报道了首个芯片级时空复用 GBS 系统——致远 3.0,具有最大的芯片级 GBS 模式数和在 1 毫秒内高达 11,059 个光子的探测事件。通过建立晶圆级薄膜铌酸锂(TFLN)中试线以及在闭环制造工作流程中进行迭代优化,我们成功地将高速电光调制器、片上波导延迟线和时空复用干涉网络集成在单个芯片上,达到了 4 GHz 的系统时钟速率。除了展示量子计算优势之外,我们还探索了 GBS 中高维模式关联的内在采样与以世界模型为例的数据驱动人工智能(AI)研究之间的本质联系。以卡门涡街作为代表性物理场景,我们将同一芯片重新编程为 GBS 驱动的世界模型,用于学习和预测流场动力学。与经典回声状态网络(ESN)基线相比,该模型以更少的可训练读出参数实现了更低的预测误差,展示了光子量子硬件在 AI 方面的潜力。
结果
整个 GBS 系统安置在一个机架中(图1a),其中包含光子源、片上量子处理单元(QPU)、光子探测和控制系统等模块。如图1b所示,时空复用的灵活性近年来已被广泛证明,延迟环和非平衡延迟线方案涵盖了量子优势、图问题和簇态制备。在此,我们将这种时空复用策略实现在集成光子芯片上,在保持该方案可扩展性的同时赋予了强大的可编程性。
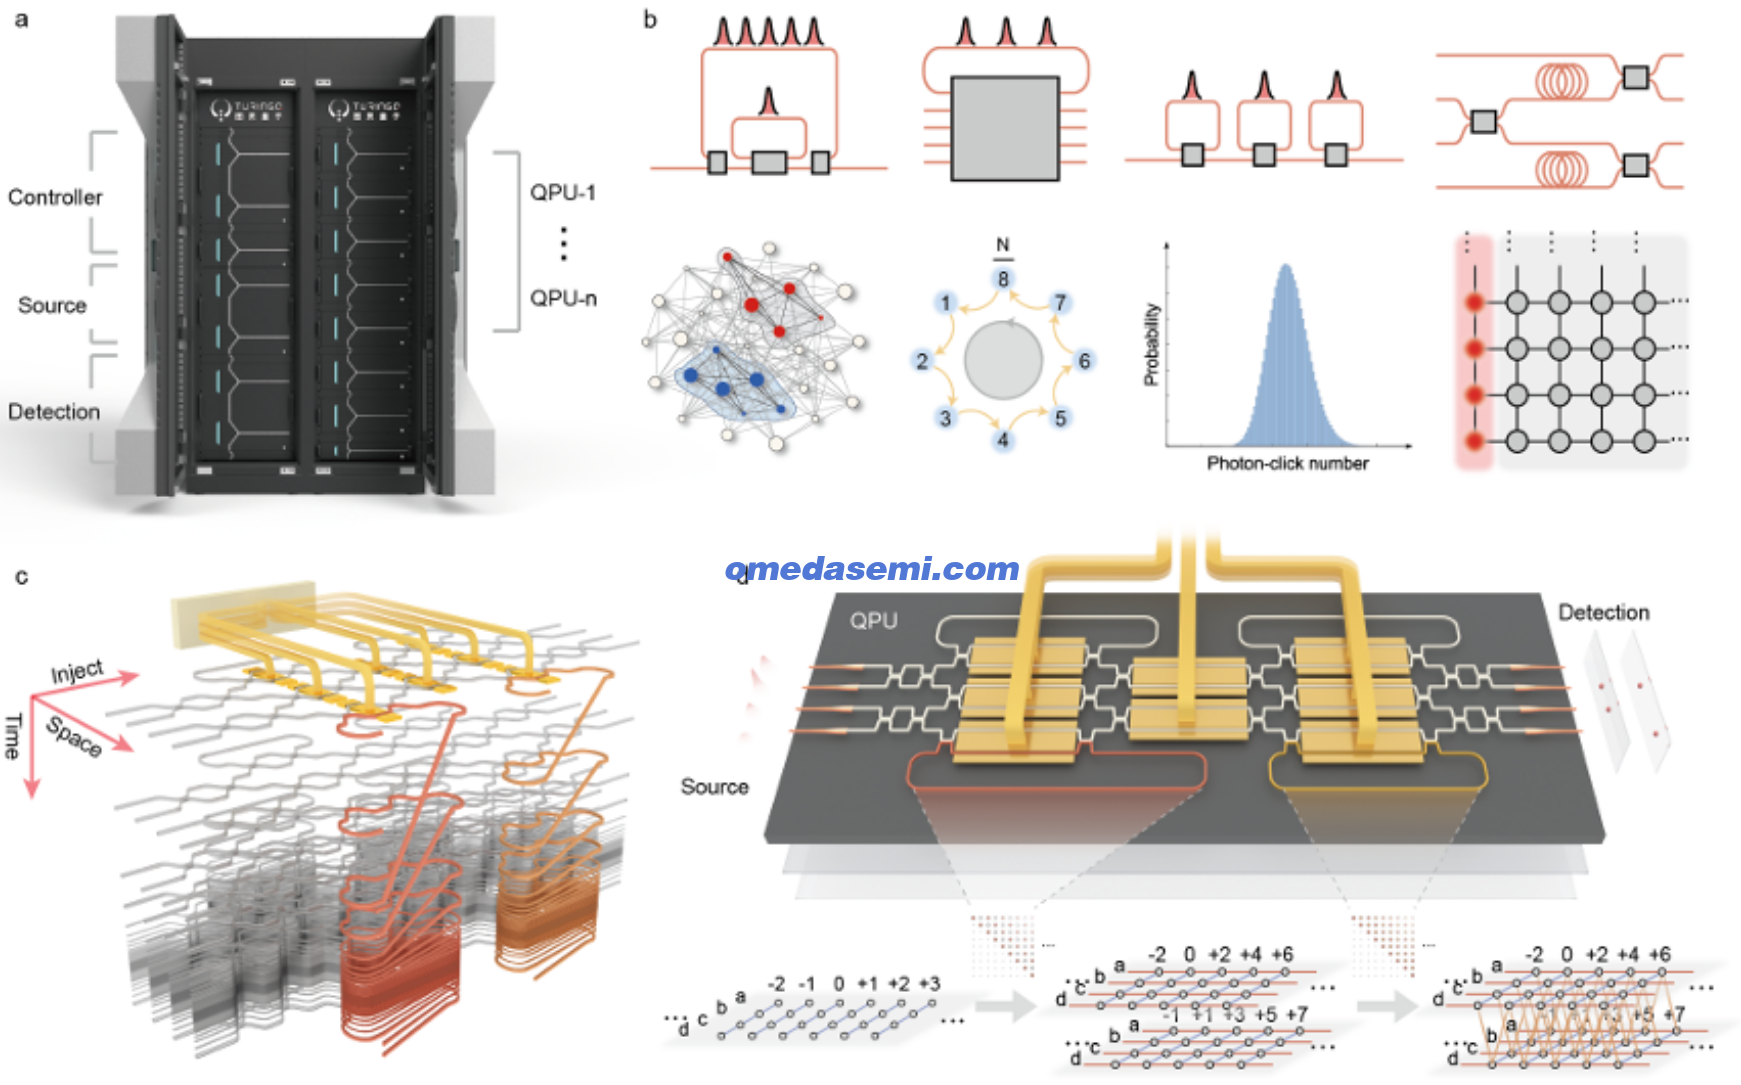
图1. 芯片级时空复用 GBS 系统致远 3.0 的示意图。a 完整系统由控制模块、量子源、量子处理单元(QPU)和探测模块组成。b 顶部:代表性的时域复用方案,涵盖延迟环和非平衡延迟线架构。四个面板从左到右分别显示了 [16] 中首次提出的嵌套延迟环、环回 [10]、级联延迟环 [11] 和非平衡延迟线结构 [19, 20]。时域复用思想首次在 [16] 中提出。底部:量子优势演示、图问题和簇态制备中与 GBS 相关的问题。c 时空复用芯片架构。该芯片单片集成了多层 MZI 网络与热光、电光调制器阵列和片上延迟环,构建了大规模、完全时空混合且高度可编程的网络。d 压缩真空被注入芯片,经过级联的时空干涉结构演化,产生时空混合的大规模 GBS 态。该态由超导纳米线单光子探测器(SNSPDs)探测以进行采样,其中所有空间模式通过伪光子数分辨探测 [63–65] 使用总共 16 个通道进行探测。
如图1c所示,干涉网络在空间和时间两个维度上构建。在每一层中,多层 MZI 网络允许光子在不同的空间模式上演化。两个不同长度的延迟环连接不同时间仓的光子。这种带有延迟环的 MZI 网络,辅以热光和电光调制能力,赋予系统在空间和时间维度上的灵活可编程性,使单个芯片能够针对不同任务重新配置。如图1d所示,压缩真空态被注入芯片,脉冲经过一系列 MZI 和延迟环路由,生成具有时空纠缠的大规模三维簇态。该态最终被传输到超导纳米线单光子探测器(SNSPDs)进行采样。
该芯片通过在六英寸薄膜铌酸锂晶圆上进行晶圆级加工制造。近年来,TFLN 因其优越的电光特性而成为一个重要的研究平台。在该材料系统上已经实现了各种高性能光电调制器 [30–32],展示了超高速光操控能力 [33, 34],以及多种频率转换器件 [35–38]。虽然 TFLN 调制器已经产生了初步的量子信息演示 [39–41],但其大规模高速调制的全部能力尚未真正用于量子计算应用。
回想一下,由判据 [15] 施加的损耗预算极为严格,技术上难以满足。为了满足这一严格的损耗约束,我们投入了 4.5 年时间建立完整的晶圆级铌酸锂光子芯片中试线。在整个开发过程中,每个结构和功能元件都通过闭环制造迭代反复优化和验证,每个完整迭代周期压缩至三周。通过详尽的参数调优和艰苦的迭代改进,我们最终满足了判据 [15] 定义的要求。我们在单次工艺中制造了集成低损耗干涉网络、高速调制器阵列和延迟环的芯片(见方法部分)。然后我们通过光纤阵列贴装和引线键合对其进行封装,最后将其组装到实验系统中,如图2a-c所示。关键器件的详细结构如图2d所示。
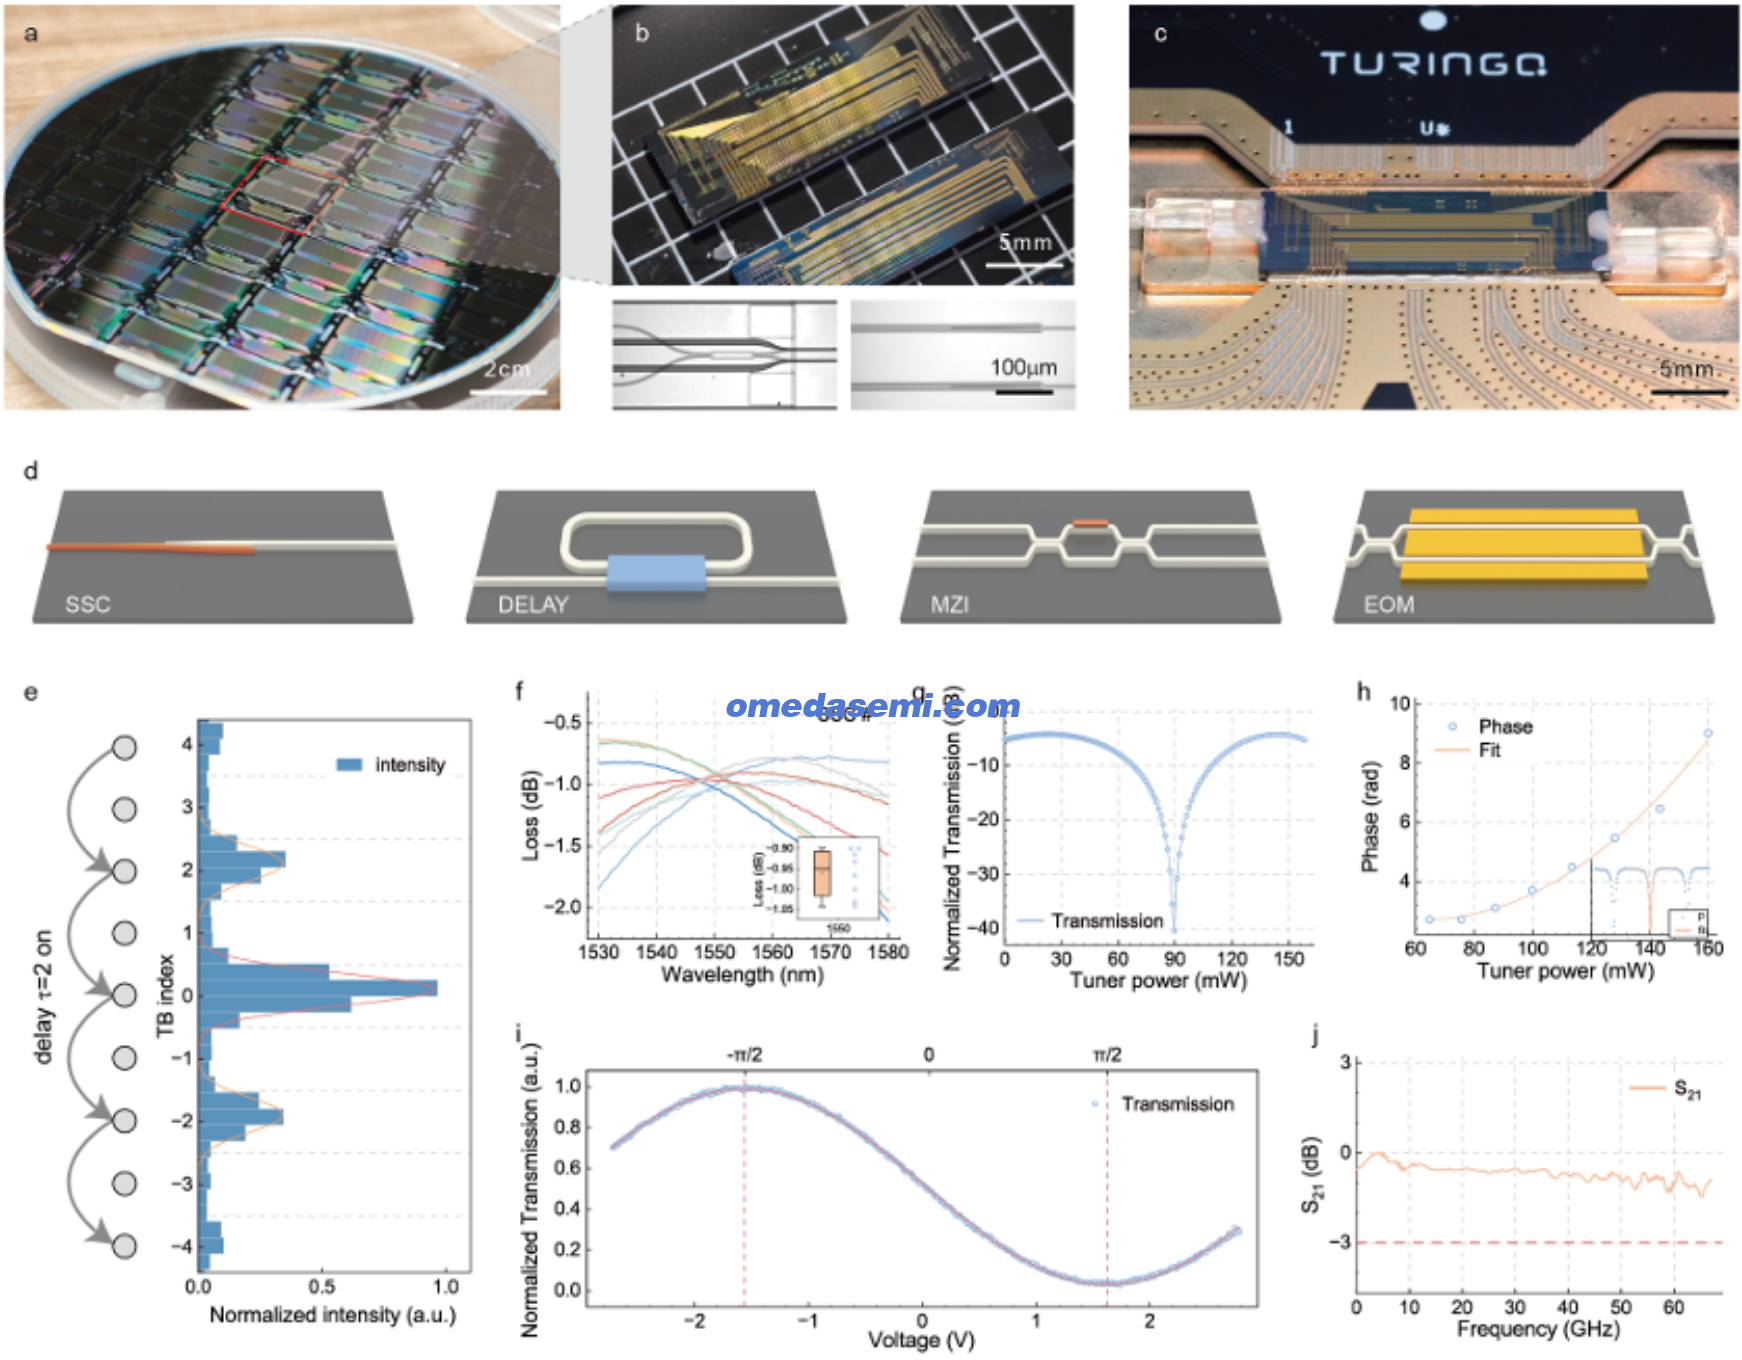
图2. 芯片制造与表征。a-c 基于铌酸锂的 TDM GBS 芯片布局。薄膜铌酸锂晶圆 (a)、制造的芯片 (b) 和封装的系统模块 (c)。d 关键器件的图示:双层模斑转换器 (SSC)、延迟环、热光 MZI 和高速电光调制器 (EOM)。e-j 器件表征。e 系统以 4 GHz 时钟速率运行;250 ps 时间仓窗口可以在时间轴上清晰划分。红线显示了到达时间的拟合,灰色虚线标记了时间仓窗口。f 多个 SSC 在 1530-1580 nm 范围内测量的透射光谱。插图显示了 1550 nm 处的损耗分布,平均每面 0.9 dB。g MZI 透射率与热光调谐功率的关系,消光比高于 35 dB。h 延迟环的调制曲线,通过谐振峰的移动来表征。i EOM 的半波电压,Vπ = 3.18 V。j 测量的片上调制器 3-dB 带宽。
为了评估当前制造工艺可实现的芯片级性能,我们在晶圆级批次上进行了器件表征,如图2e-j所示。系统以 4 GHz 时钟速率运行,这是迄今为止量子系统中报道的最高速率,时间仓窗口为 250 ps。图2e显示了单脉冲注入下符合时间差分布的一个示例,表明时间仓窗口可以在时间轴上清晰划分。模斑转换器在 1530-1580 nm 范围内表现出均匀透射,在 1550 nm 处每面平均损耗为 0.9 dB。热光 MZI 在透射光谱中随着加热功率的变化表现出清晰的干涉条纹,消光比高于 35 dB,如图2g所示。在图2h中,延迟线上的相位调制通过谐振峰的移动来表征。电光调制器实现了 3.18 V 的半波电压,电光 S21 响应产生超过 67 GHz 的 3-dB 带宽,如图2i-j所示,支持系统以 4 GHz 时钟速率运行。整个系统的温度稳定在 0.01 °C 以内。
我们使用五种不同的泵浦功率进行采样实验,并获得每个样本总点击数的归一化概率分布,每个样本对应于 1 毫秒内的采样过程。我们显示分布随着泵浦功率的增加向更大的光子数移动。如图3a所示,在最高泵浦功率 300 mW 下,单个样本中的最大点击数高达 11,059——这一数值远超以往 GBS 实验中报道的任何值,使得输出分布的精确复现超出经典计算能力(更多细节见方法部分)。
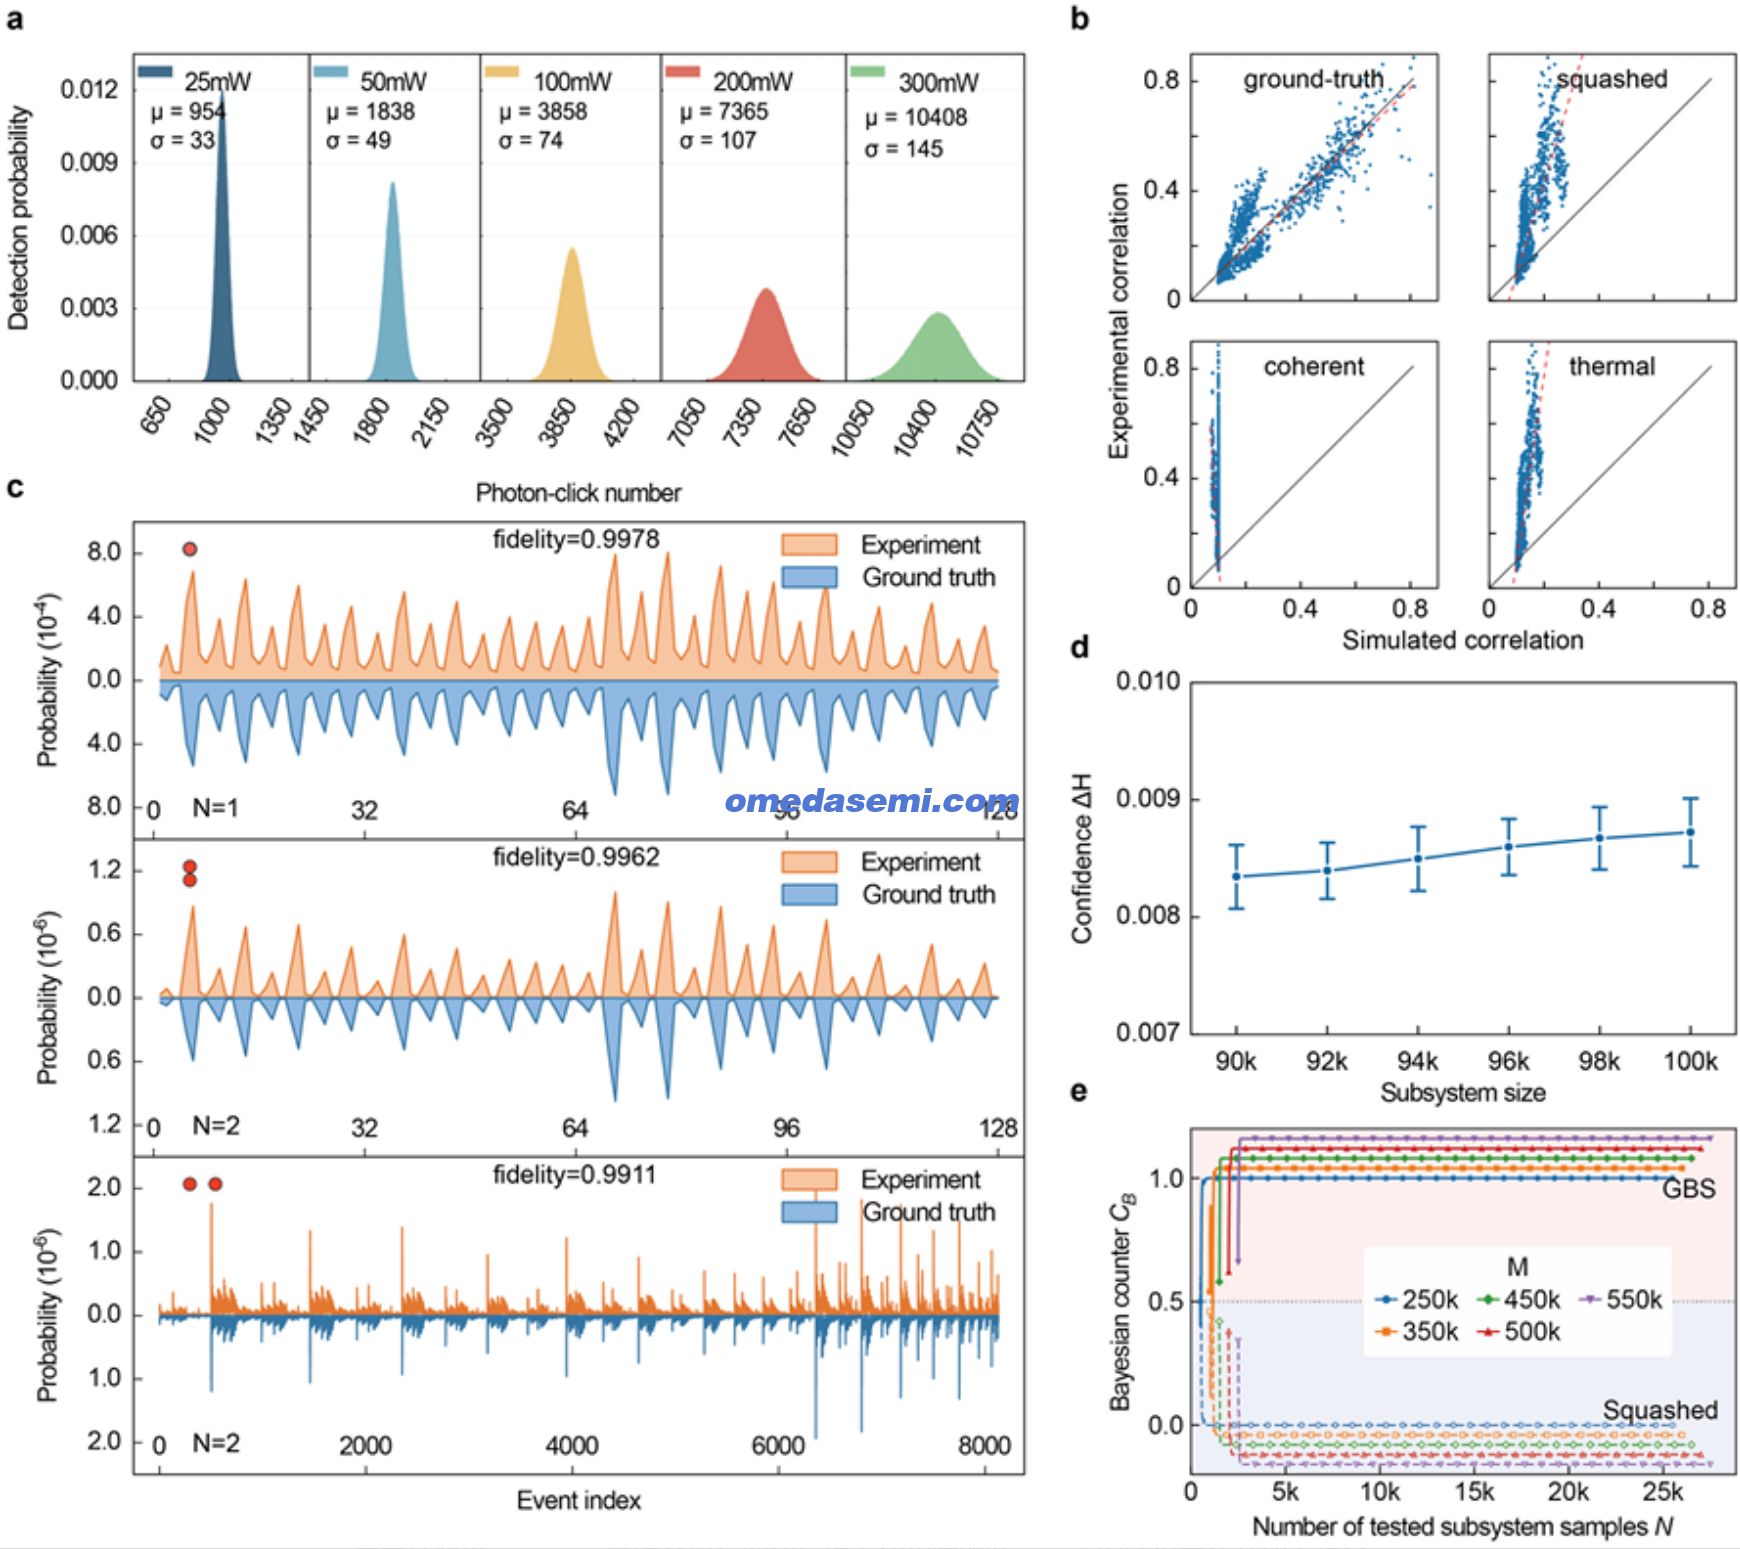
图3. GBS 器件的实验结果与验证。a 五种泵浦功率下光子点击数归一化概率分布。在最高泵浦功率下,最大光子点击数超过 10,000。b-c 小规模 GBS 验证。b 在具有相同一阶矩的四种假设下,二阶相关函数的仿真-实验比较,证实实验输出的光子统计与 GBS 基准真值一致。c 少光子子空间中每种配置的实验与理论概率比较,单光子、双光子聚束和双光子反聚束保真度分别为 0.9978、0.9962 和 0.9911。d 贝叶斯置信度。所有得分均高于零,表明该系统生成的样本比任何对抗性欺骗分布更接近基准真值分布。e 贝叶斯计数器。得分的逐批演变,随着样本数量的增加,GBS 基准真值与每种欺骗模型之间的区分稳步发散,证实了 GBS 模型。
为了验证实验输出的统计特性,我们首先在小规模系统上进行验证。如图3b所示,我们在四种假设——GBS 基准真值、热光、相干光和压缩态——下从理论上计算光子相关函数,并将其与实验结果进行比较。为了公平比较,所有假设下的一阶矩(每模平均光子数)均根据实验校准值设定。只有 GBS 假设产生的数据点位于对角线上,而其他三种模型表现出明显偏差,证实了输出光子统计与 GBS 理论一致。此外,我们比较了少光子符合的每种输出配置的理论和实验概率分布。三种情况——单光子、双光子聚束和双光子反聚束——的理论与实验结果之间的保真度分别为 0.9978、0.9962 和 0.9911,如图3c所示,验证了实验分布。
我们进一步对实验数据进行贝叶斯分析 [42],以在模型层面验证系统的输出统计(更多细节见方法部分)。首先,将贝叶斯置信度检验应用于一个 30 光子子系统,所有置信度得分均为正,并随子系统规模增大而增加,表明生成的样本更接近真实 GBS 分布而非欺骗模型,如图3d所示。此外,以压缩态欺骗模型为例,贝叶斯计数器追踪符合得分随样本批量累积的演变,显示 GBS 假设与压缩态欺骗模型逐渐变得更加可区分,如图3e所示,证实输出是真正的 GBS 而非任何经典欺骗模型。结合精确的少光子分布比较,贝叶斯分析确立了系统的输出在统计和模型层面均与 GBS 匹配。
在数千光子规模上进行采样并展示量子优势,仅回答了“能有多大”的问题。近年来,GBS 研究——包括本工作的结果——一直受到持续的规模竞赛驱动,模式数和光子数随时间稳步增长。然而,宣称量子优势是必要的里程碑,而非最终目的地。本工作的下一步是追求实用性,这需要三种工程品质:通过晶圆级批量制造实现经济性,通过片上集成实现鲁棒性,以及通过灵活重构实现可用性。芯片级集成、时空混合和高速可编程性的结合,将该系统从仅仅“大”的 GBS 转变为“可用”的 GBS,如下文所示的 GBS 驱动光子原生世界模型所证明。
越来越多的研究致力于量子计算与人工智能的协同,其中量子态和可编程动力学作为数据驱动学习的原生资源 [43, 44]。世界模型为这种融合提供了预测焦点:从观测中学习物理动力学的表示,并利用它们预测未来状态 [45, 46]。这些预测性表示支持规划、仿真和渲染等应用(图4a)。
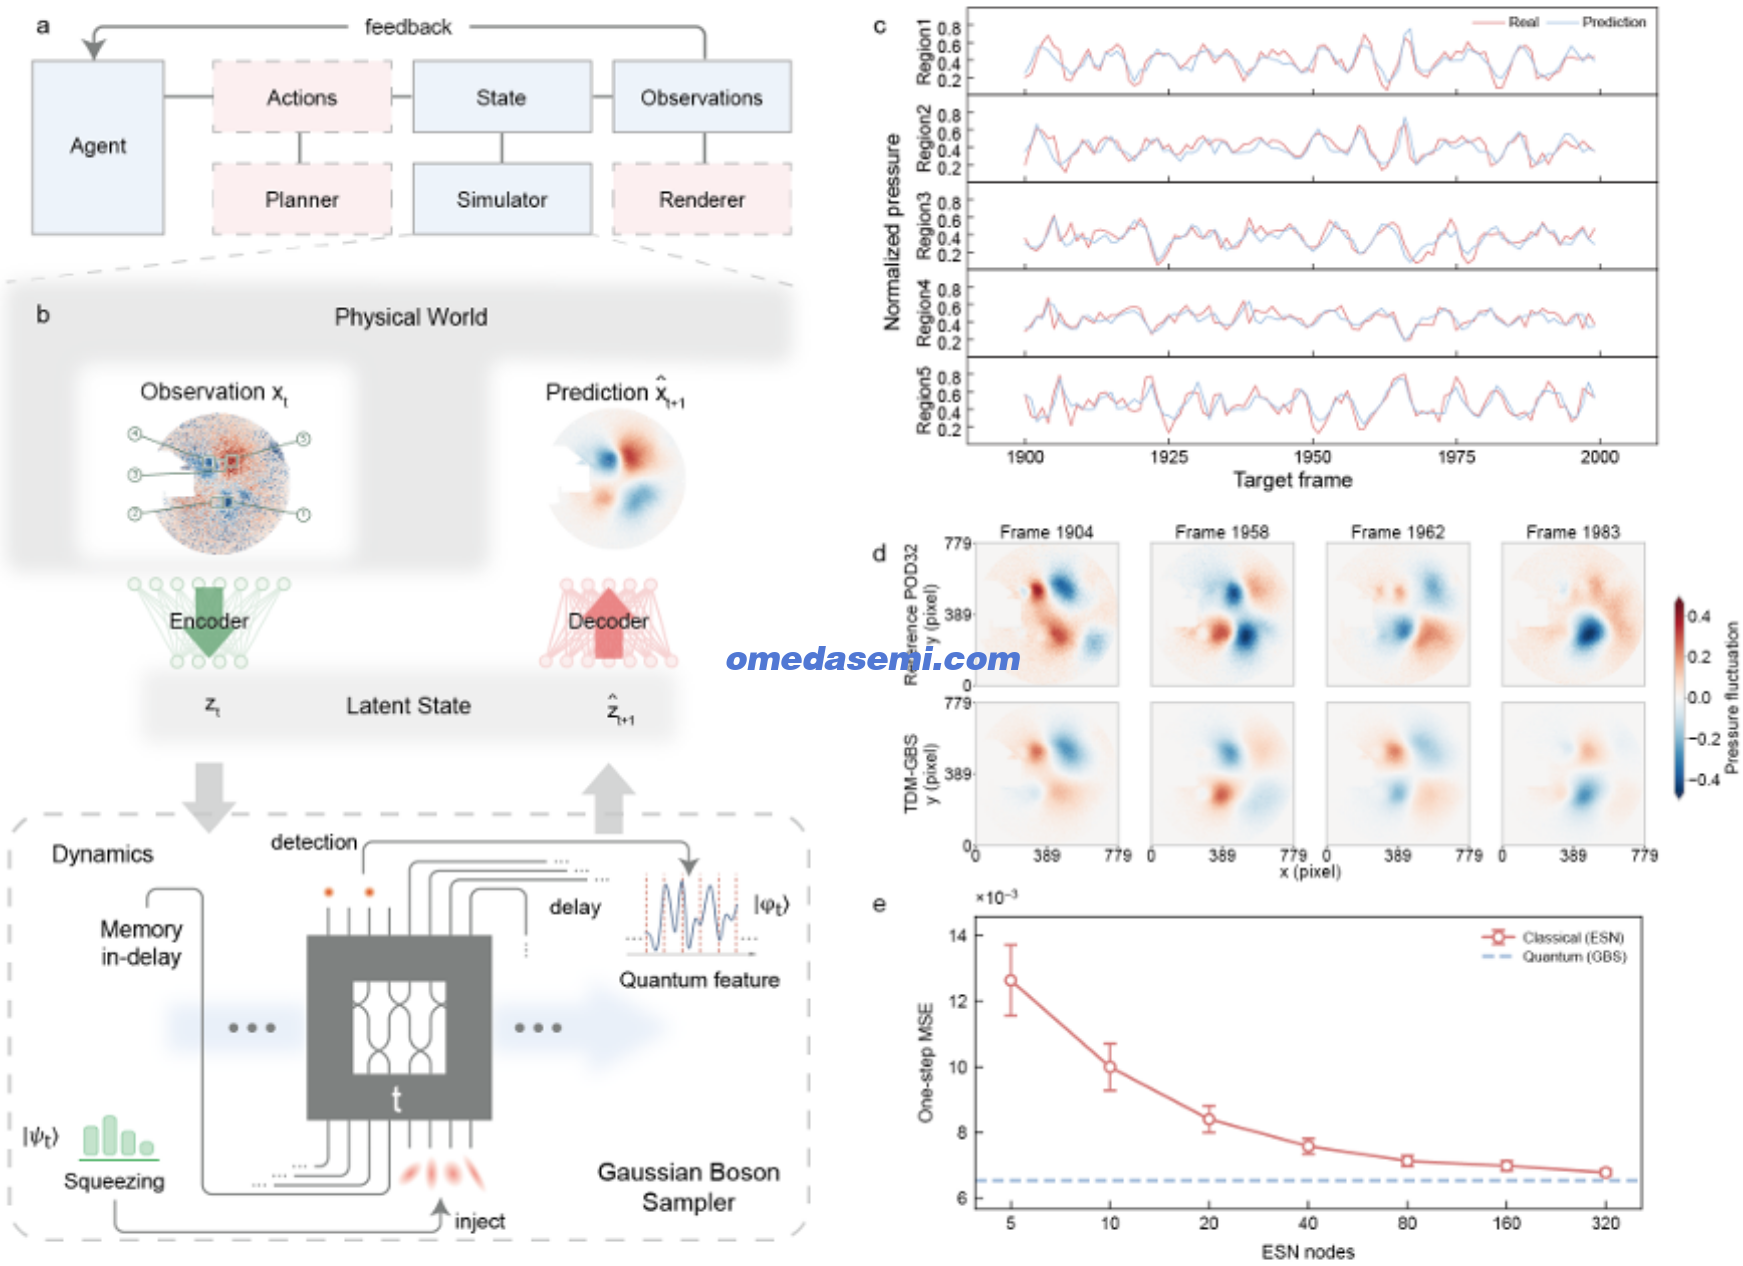
图4. GBS 驱动的世界模型。a 世界模型的功能分类——规划器、模拟器和渲染器——我们的系统属于模拟器类别。b GBS 驱动的世界模型的闭环框架:物理世界 → 观测 → 编码器 → GBS 动力学模型和记忆 → 解码器 → 未来状态预测,其中 GBS 作为环路中的动力学引擎。c 真实涡街(红色)与 GBS 预测(蓝色)的潜变量演化比较。d 代表性流场重建:顶行显示原始涡街流场,底行显示从 GBS 驱动的世界模型预测重建的流场。e GBS 驱动的世界模型与经典方法(ESN)在卡门数据集上的预测误差比较。
近期关于量子增强长短期记忆网络和量子储备池计算的工作已经展示了利用量子动力学系统进行时间预测 [47–50]。受这些进展的启发,我们实现了一个以重构芯片作为其动力学引擎的 GBS 驱动世界模型。这种光子量子世界模型利用了光子原生的时间记忆:光学延迟环保留部分演化的光学状态,并将其与后续输入混合。干涉和光子计数随后产生编码输入历史信息的特征。
我们通过对卡门涡街压力动力学的一步预测来演示该模型 [48]。在图4b所示的架构中,编码器将观测到的压力场的五个区域均值映射为光学输入。训练好的线性读出使用测得的光子特征来预测下一个五维压力状态,然后由经典空间解码器映射回二维场(见方法部分)。每次预测使用观测到的当前状态以及内部光学记忆。图4c比较了参考和预测的区域平均压力(红色:参考;蓝色:预测)。图4d比较了预测的压力场重建与代表性帧处参考场的秩-32 本征正交分解(POD)重建,显示主要空间结构一致。
我们使用相同的请求压缩输入和时间评估片段,将 GBS 驱动的世界模型与经典 ESN 进行基准比较(图4e)。尽管 ESN 预测误差随着网络规模从 5 个节点增加到 320 个节点而降低,但光子量子世界模型在最终 100 帧的每个测试规模上均保持比 ESN 均值更低的均方误差(MSE)。实验测量的光子特征产生的一步 MSE 为 6.537×10⁻³,而 320 节点 ESN 为 (6.781±0.091)×10⁻³,其中不确定度表示 100 次随机初始化的样本标准差。因此,量子模型相对于最大评估 ESN 的平均 MSE 降低了 3.60%。在该片段上,其误差也低于每个测试网络规模下 100 次评估的 ESN 初始化中的最低误差。
该光子模型以比 320 节点 ESN 少 84.1% 的可训练读出参数实现了这一精度(见方法部分)。更低的预测误差和更小的可训练读出共同展示了 GBS 驱动的世界模型在记录轨迹上进行参数高效动力学预测的潜力,将可重构光子量子硬件的使用扩展到采样基准之外的 AI 任务。
讨论
总之,我们展示了首个芯片级时空复用 GBS,其干涉网络、调制器阵列和延迟环单片集成在薄膜铌酸锂平台上。系统以 4 GHz 时钟速率运行,并在最大规模下产生超过 10,000 个光子的样本。我们通过光子相关函数、少光子概率分布和贝叶斯分析验证了结果,共同证实系统输出与 GBS 基准真值一致。在复杂性方面,我们使用矩阵乘积态(MPS)方法(目前可用的最佳经典算法)评估了经典模拟成本,表明此规模下的经典模拟在计算上是不可行的。基于同一芯片构建的 GBS 世界模型进一步展示了系统在量子优势演示之外的实际计算任务能力。总体而言,这些结果表明我们的芯片级时空复用系统同时提供了规模和可编程性,将 GBS 从专用的采样实验演变为多功能的量子计算平台。
如上所述,规模竞赛本身并非目的;下一个方向是从规模竞争转向实际应用。系统的工程品质——经济性、鲁棒性和可用性——是未来进步的基准。因此,有必要将压缩光源和探测器集成到芯片上,以消除剩余的自由空间组件,同时降低波导和耦合损耗以进一步扩展系统规模 [51]。共封装光学技术 [52–54] 以及高速电读出和控制系统 [55–57] 也可能为可扩展光子量子处理单元带来巨大益处。从更广阔的视角来看,芯片级 GBS 的意义超越了量子优势演示。GBS 驱动的世界模型通过将光子原生时间记忆与物理动力学的学习预测相结合, exemplifying 了量子硬件与 AI 的融合。作为一个可编程光子量子平台,它为各种光子量子计算任务提供了硬件基础,最终目标是容错光子量子计算 [58–61]。充分利用量子工程 thus 赋能芯片级光子量子计算平台,并拓宽实际探索的视野。
方法
低损耗、高速芯片的晶圆级制造
该芯片在 6 英寸市售绝缘体上薄膜铌酸锂晶圆上制造,该晶圆由 400 nm 厚的单晶 x 切 LiNbO₃ 层堆叠在 4.7 µm 埋入式热氧化(BOX)层上组成(NanoLN)。波导使用深紫外(DUV)扫描仪(KrF)进行图案化,然后通过基于 Ar⁺ 的刻蚀工艺刻蚀 200 nm 的 LN 转移到铌酸锂(LN)层。波导层由等离子体增强化学气相沉积沉积的 1200 nm 氧化硅包层保护。由氮化钛制成的 175 nm 厚加热器使用刻蚀工艺制造。由金制成的金属电极使用剥离工艺制造,未加载电极的厚度为 1000 nm。最后,通过各向同性等离子体硅干法刻蚀去除加热器部分下方的硅衬底。
GBS 验证指标
少光子分布
为了定量评估实验结果的准确性,我们在 32 个时间步上累积少光子事件统计,并分别计算单光子、双光子聚束和反聚束事件的保真度。用 p_i 和 q_i 表示实验和理论分布,保真度(巴氏系数)定义为
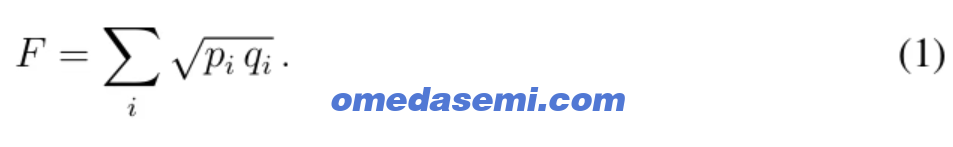
32 个时间步共包含 128 个模式,分别为 P₁、P₂ 和 P₁,₁ 产生 128、128 和 8128 种可能的图案。在理论模拟中,我们在 DeepQuantum 仿真框架 [62] 内构建了时空复用电路,并将 32 个时间步的电路展开为其全局等效形式,从而高效地获得相应的理论分布。
光子相关函数
g⁽²⁾ 矩阵通过正规序定义为 g_{i,j}⁽²⁾ = ⟨n̂_i n̂_j⟩ / (⟨n̂_i⟩⟨n̂_j⟩),其中 n̂_i = â_i† â_i,对角和非对角元素可进一步写为
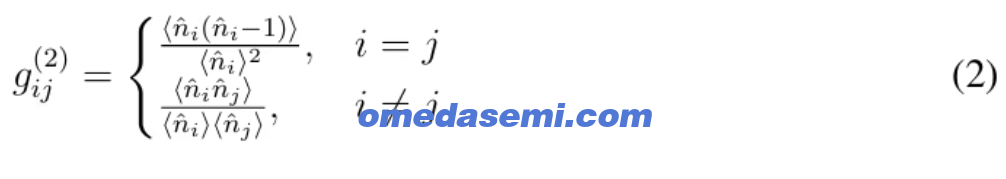
在我们的时空复用架构中,模式索引定义为 i = 4 × t + s,其中 t 表示时间步,s ∈ {1, 2, 3, 4} 表示空间模式索引。
为了验证系统输出的关联结构和量子统计特征,我们进行了 32 个时间步(共对应 128 个模式)的小规模基准测试。将实验测量的 g⁽²⁾ 矩阵与压缩态、相干态、热态和压缩态的理论预测进行了比较。
贝叶斯计数器
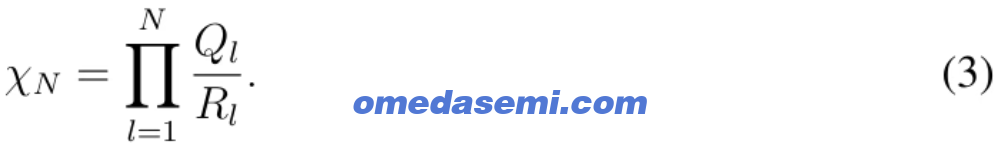
对于第 l 个实验样本,令 Q_l = P_GBS(l),R_l = P_mock(l),其中 Q_l 是目标 GBS 模型赋予的概率,R_l 是给定模拟模型赋予的概率。累积似然比定义为
假设 GBS 模型和模拟模型的先验概率相等,样本来源于 GBS 模型的后验概率由下式给出
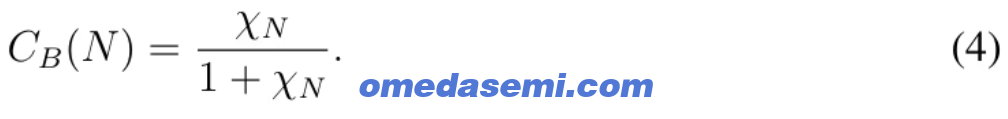
因此,C_B(N) > 0.5 支持 GBS 模型,而 C_B(N) < 0.5 支持模拟模型。
子系统贝叶斯置信度
假设两个假设:H₀ 是目标 GBS 分布,H₁ 是欺骗模型分布。贝叶斯置信度本质上是样本在两个模型下的平均对数似然比:
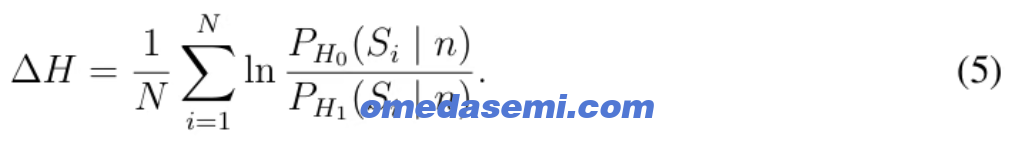
这里,总点击数是固定的。因此,比较解决了以下问题:给定相同的总点击数,事件更符合 GBS 模型还是欺骗模型。判定标准为:如果 ∆H > 0,则实验样本支持 GBS 模型。
量子优势基准测试
为了评估本工作的经典可模拟性,我们基于参考文献 [3, 15] 进行仿真评估。参考文献 [15] 表明,带有损耗的协方差矩阵可以分解为量子部分 V_p 和经典部分 W,从而能够通过 MPS 方法高效模拟有损 GBS 分布,其中模拟复杂度主要由量子部分 V_p 决定。对于中等规模系统,V_p 可以通过半定规划(SDP)获得。对于大规模系统(m > 2000),参考文献 [3] 进一步提供了一种解析构造方法来近似生成 V_p 并估计所需的键维数。基于上述方法,我们对本实验的经典模拟复杂度进行了基准评估,旨在量化不同系统规模下的可模拟性边界,并为讨论量子优势提供基础。
在数值模拟中,假设片上延迟线损耗为 2 dB/τ、光纤延迟线损耗为 2 dB、空间损耗为 5 dB,以及 10,000 个时间步(M = 40,000 个模式),有效光子数 N_eff 达到 117.9。对于 d = 3 和键维数 χ ~ 10⁴,截断误差超过 0.05。根据计算复杂度

以及 NVIDIA A100 图形处理单元(GPU)每秒浮点运算次数(FLOPS)基准,即使有足够的内存,经典模拟一个 2.5 µs 的 GBS 采样任务也至少需要 9.7 × 10⁶ 年。
GBS 驱动的世界模型
动力学学习旨在从观测测量中推断物理演化规律,以预测后续的状态转变。源于早期认知科学的见解,研究人员已经开发了物理感知建模方法,如物理信息神经网络,将控制方程作为损失约束嵌入,以强制物理一致性。然而,这种依赖方程的方法可能会受到复杂、部分已知、多模态和多尺度现实世界场景的挑战。相比之下,世界模型框架纯粹从观测数据中提取通用、可迁移的动力学表示,而无需对底层物理有完整的先验知识。
我们研究了在 780×780 网格上部分观测的卡门压力动力学的预测,使用 2,000 个快照,按时间顺序分为 1,900 个用于训练(1,500 个拟合 + 400 个验证)和 100 个用于评估。世界模型由编码器、动力学模块和空间解码器组成。编码器将每个压力场压缩为五个区域均值,这些均值经过标准化、裁剪并量化为 64 级压缩值。动力学模块——由五个并行时域复用 GBS(TDM-GBS)通道(量子)或 ESN(经典)实现——将编码的当前观测与其内部记忆相结合,预测下一个五维压力状态。解码器然后使用秩-32 POD 基和高斯径向基函数(RBF)映射器从预测状态重建完整压力场。
两种动力学读出均在拟合子集上使用 MSE 和 L2 正则化进行训练,超参数通过验证选择并在完整训练数据上重新拟合。评估报告在原始压力尺度上的预测误差。对于经典基线,具有 5–320 个节点的 ESN 在每个规模上进行了 100 次随机初始化测试,结果以运行间的均值和标准差总结。
对于参数比较,我们将可训练读出系数与固定网络系数和电路相位设置分开计数,排除归一化统计量以及公共状态编码器和空间解码器。光子模型使用 50×5+5 = 255 个可训练读出参数(包括输出偏置)将 50 个测量特征映射到五个输出。320 节点 ESN 使用 320 × 5+5 = 1,605 个可训练读出参数,对应于光子模型减少 84.1%。ESN 还包含 320 × 6 + 320² = 104,320 个固定输入和循环系数(包括输入偏置),使其总网络系数达到 105,925 个。光子动力学由在五个输入流之间共享的 20 个固定 MZI 相位设置配置。
文章名:A Chip-scale Space-time Multiplexed Gaussian Boson Sampling Processor Beyond 10,000 Photons
作者:Yu-Xuan Fu¹, He-Yu Shen¹, Ke-Ming Hu², Jun-Jie He², Yun-Long Nie¹, Hang Song¹, Bao-Jing Liu¹, Le-Si Yang², Xiao-Yu Wu², Pei-Lin Du², Yu-Ze Zhu², Yi Xie¹, De-Hui Huang¹, Yu-Fei Liu², Hai Yan², Jin-Hong Chen³, Yu-Lin Yu², Chuan-Yan Peng², Wen-Hao Zhou¹, Feng Lu¹, Yu-Quan Peng², Chen-Shuo Xia², Zhi-Chao Wang², Zhe-Han Li², Lin Chen², Chao-Yang Zhang², Chun-Yan Jin², Yan-Rong Zong², Xiao-Yun Xu¹, Jian-Peng Dou⁴, Xiao-Tian Fang⁴, Pei-Qi Zhou², Hao Tang¹,*, Chang-Shun Wang¹,*, Lin Yang²,†, Xian-Min Jin¹,²,³,⁴,⁵,‡
单位:1Center for Integrated Quantum Information Technologies (IQIT), School of Physics and Astronomy and State Key Laboratory of Photonics and Communications, Shanghai Jiao Tong University, Shanghai 200240, China
2TuringQ Co., Ltd., Shanghai 200240, China
3Chip Hub for Integrated Photonics Xplore (CHIPX), Shanghai Jiao Tong University, Wuxi 214000, China
4Atomology Co., Ltd., Shanghai 200240, China
5Hefei National Laboratory, Hefei 230088, China